先说背景:这不是你一个人的故障
2026 年 11 月 2 日凌晨,俄罗斯主机商 Beget 通知用户,其基础设施遭到大规模网络攻击,部分服务中断。据报道,这次攻击可能导致托管在 Beget 的近 50 万个网站出现访问问题,而截至通报时,官方仍在评估全部影响,没有给出完全恢复的时间表(相关报道)。
这件事离个人站长并不远:你的博客、小服务大概率只跑在一家主机商的一台机器上,机房出问题,网站就跟着下线;很多人直到那一刻,才发现自己既没有异地备份,也没有备用落点,只能干等官方通告。
这篇不教你防攻击。这篇给你一份事前准备 + 事中应对的清单,照着做,下次再遇到类似事件,你至少有选择,而不是只能刷新状态页。
前置知识:你有一台 VPS,上面跑着博客或小服务,会用 SSH 登录服务器。文中不涉及任何真实服务器地址和密钥,出现的主机、域名一律用泛称代替。
1. 先判断:是全网故障,还是只有你打不开
网站打不开时,别急着重启服务器、重装系统。先花 5 分钟定位问题层级:
- 看主机商状态页:正规厂商都有状态页或公告频道,先确认是不是机房、网络或平台级故障。如果是平台级事件,你在自己机器上折腾没有用。
- 换网络、换设备再试一次:手机流量、家里宽带各打开一次,排除本地网络问题。
- 查第三方监测:用公开的宕机监测站搜一下主机商名字,看是不是大面积报告。
- SSH 还能不能连:能连上 SSH 但网站打不开,多半是服务或网络层问题;SSH 也连不上,才优先怀疑机器或机房。
2. 故障期间的“三不做”
- 不重装、不删数据:先保数据,再谈恢复。
- 不反复改 DNS:来回改记录只会让恢复后的生效时间更难预测。
- 不轻信“内部消息”:以官方通告为准,别跟着不明来源的“修复教程”乱改配置。
3. 真正的底牌:平时就有的异地备份
主机商提供的快照(snapshot)不等于备份:快照通常只能恢复到同一家厂商,厂商平台本身出问题时,快照也可能一起不可用。靠得住的备份要满足两点:
- 至少一份在别处:另一台 VPS、家里 NAS,或者对象存储都行。同一块硬盘上的“备份”,硬盘挂了就一起没。
- 定期验证能恢复:没演练过的备份等于没有备份。每季度抽一次备份文件,在备用机器上实际解压、跑起来一次。
具体怎么做,可以看本站的自动备份脚本篇:每天定时打包关键目录、只留最近几份、可选推送到异地,一次配置、长期受益。
4. 把 DNS 的 TTL 平时就设低
TTL 是 DNS 记录的缓存时间。平时把常用记录设到 300 秒左右,代价只是解析请求稍多,换来的是:真要切到备用机时,新地址几分钟到十几分钟内就能陆续生效,而不是等几小时甚至一天。
注意:TTL 要在出事前改好,出事后再改,旧缓存仍按原 TTL 过期;DNS 传播本身也有延迟,别指望改完立刻全网生效。
5. 准备一个平时不用的备用落点
备用落点不用和主站同配,目标是主站下线时先把访问接住:
- 静态版先行:博客类站点可以平时就生成一份静态版本,托管在静态托管平台上;主站一挂,改一条 DNS 就能先恢复阅读。
- 备用机保持“能开机”:一台低配备用 VPS,平时只同步数据和部署脚本,不用跑满服务;主站出事时再把服务拉起来。
- 部署脚本一键化:把“装环境、拉代码、起服务”写成脚本,存在代码仓库,而不是只存在主站目录里。
这一步花钱最少、收益最稳:买备用机之前,先按双 11 选购避坑清单里的办法算清续费总价,别为“备用”二字买下用不上的高配。
6. 监控要先于故障,而不是故障后才装
一台 7×24 小时跑着的服务,值得一个独立的外部监控:监控要放在被监控机器之外,同机监控在机器挂掉时也会一起失声;告警通道至少两条,别只依赖一种;监控项不用多,HTTP 是否 200、证书是否快过期、磁盘是否快满三项,能覆盖个人站点的大多数半夜事故。
| 场景 | 该做的事 | 别做的事 |
|---|---|---|
| 刚发现打不开 | 看状态页、换网络复现、确认 SSH | 立刻重装、删数据 |
| 确认是平台故障 | 等官方通告、准备备用落点 | 反复改 DNS、信小道消息 |
| 恢复后 | 核对数据完整性、确认备份链没断 | 以为“恢复了就等于没事了” |
恢复之后,别忘了收尾
恢复后先做三件事:核对数据有没有缺失或回滚;通报涉及入侵就改掉相关账号密码和密钥;把教训写进清单——备份按时跑了吗、备用落点真拉起来了吗、TTL 早该调低了吗。
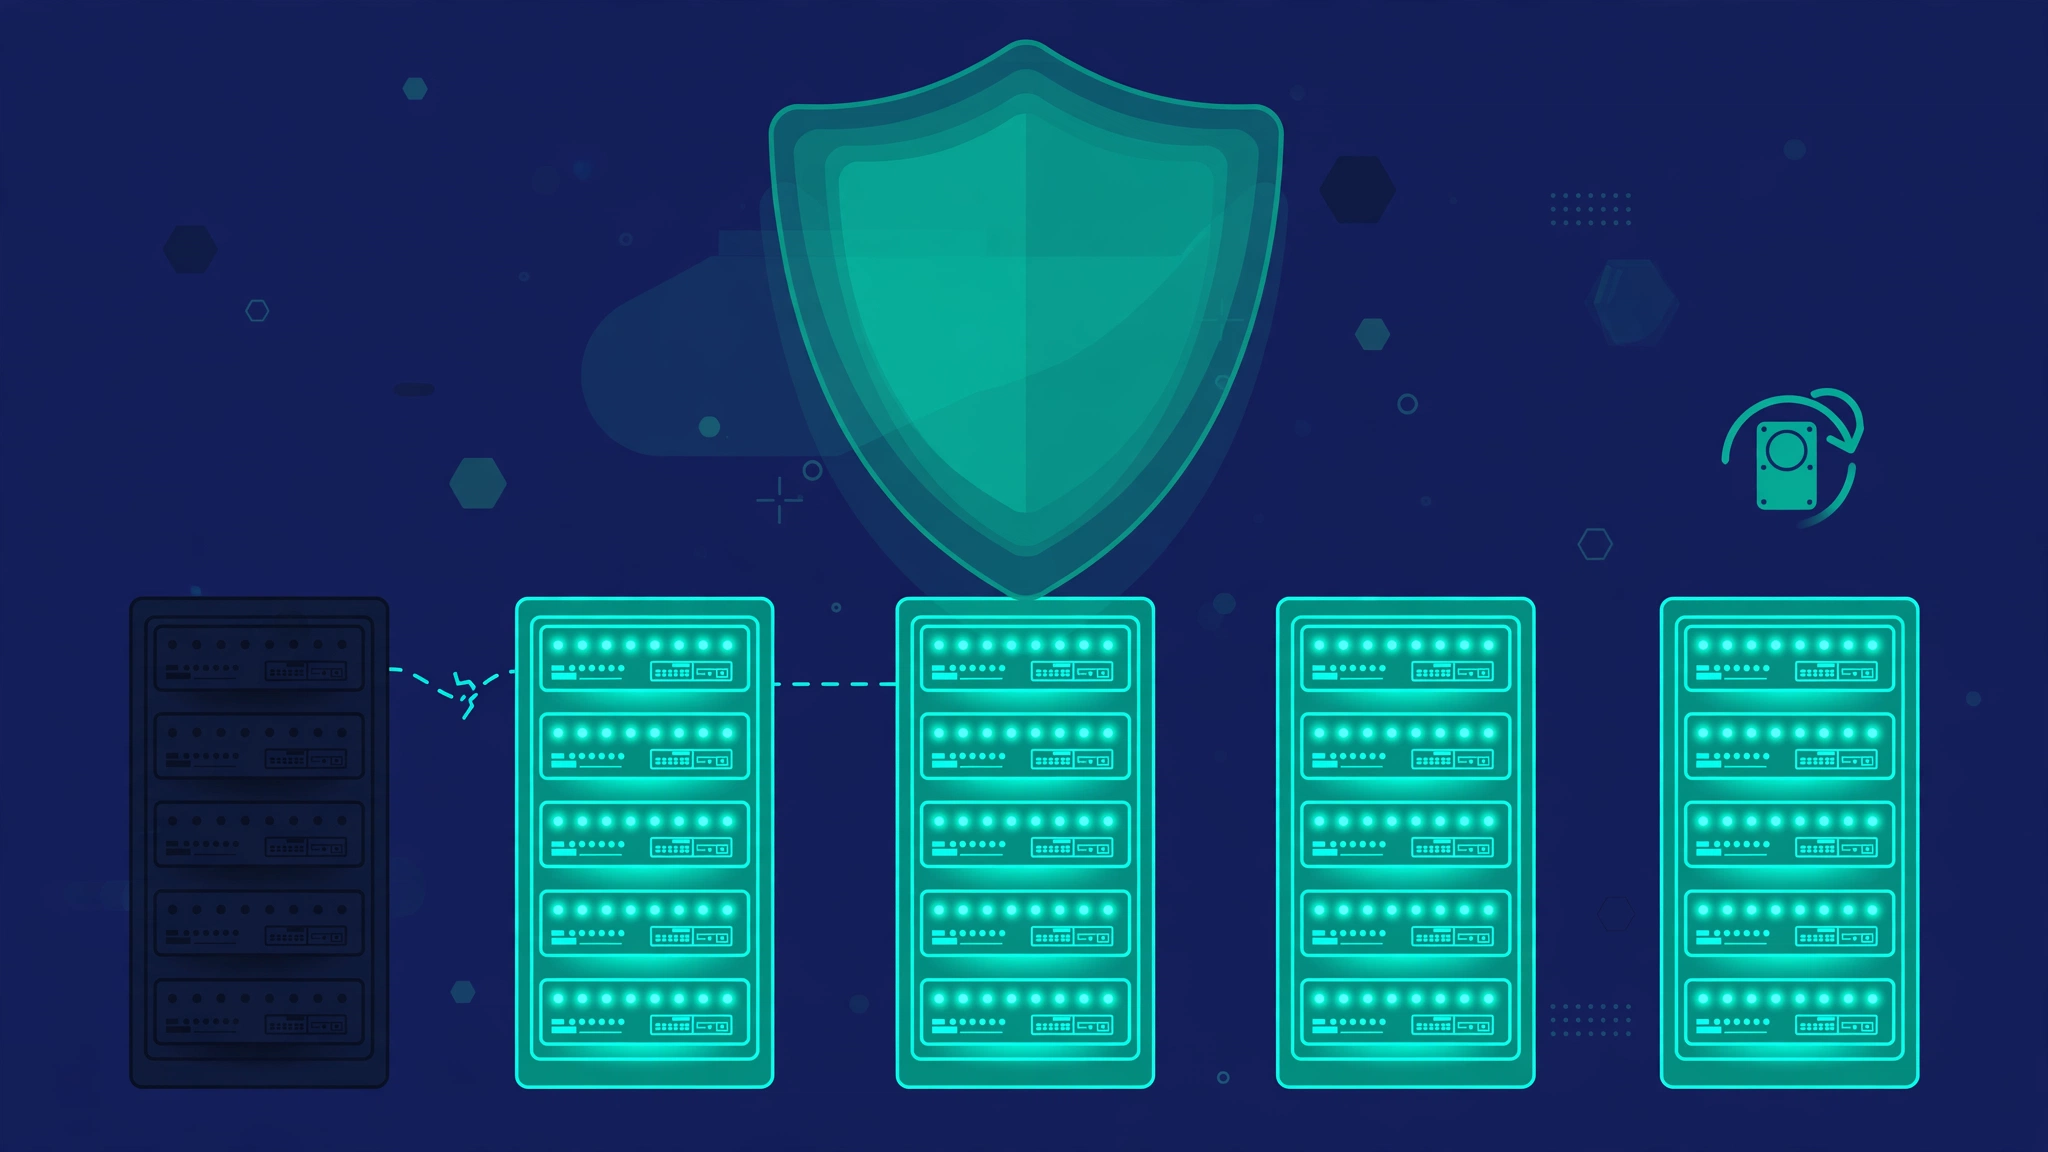
主机商被攻击,个人站长防不住,也没必要为此焦虑。能做的,是把“单点故障”变成选择题:备份在异地、DNS 能快切、备用落点能开机、监控先于故障。有了这四样,下次再看到“大规模中断”新闻,你的第一反应是“按清单走”,而不是“完了”。